
論文資訊#
| 項目 | 內容 |
|---|---|
| 發表 | Knowledge-Based Systems, Vol. 304, 112442 (2024) |
| 標題 | Dynamic traffic network representation model for improving the prediction performance of passenger flow for mass rapid transit |
| 作者 | Jheng-Long Wu, Wei-Yi Chung, Yu-Hsuan Wu, Yen-Nan Ho |
| DOI | 10.1016/j.knosys.2024.112442 |
| 程式碼 | 沒有獨立 repo;預訓練部分沿用 IIAI-AAI 2021 的 repo |
這篇是 A Dynamic Embedding Method for Passenger Flow Estimation 的期刊延伸版。我在 2021/06 到 2022/01 之間負責期刊稿的中英文撰寫與實驗,論文在 2024 年正式刊出。
以下內容依我手上 2022/01 的投稿稿件整理。期刊審稿期間經過多輪修改,正式版的模型細節與數字可能不同,引用請以期刊版本為準。
一句話總結:研討會版證明了「動態站點嵌入比靜態嵌入好」,期刊版把它推得更遠。預訓練目標從兩個擴充到四個,讓 BERT 學到更多空間概念;下游從 GMAN 換成自己設計的三層階層式注意力模型(HAN),分別處理時間、站點、路線。加入 BERT 表徵後,20 站平均 MAE 從 290.58 降到 175.84,尖峰時段的改善最明顯。
和研討會版的差異#
| 面向 | 研討會版(IIAI-AAI 2021) | 期刊版(KBS 2024 投稿稿) |
|---|---|---|
| 預訓練目標 | SDE + MFP(程式中另有相鄰站判斷) | MFP + SRP + ASP + SDE,共四個 |
| 下游模型 | GMAN,只替換 Spatial Embedding | 自行設計的三層 HAN(時間 → 站點 → 路線) |
| 挑站方式 | 轉乘、非轉乘各 10 站 | 一樣 20 站,但用 KL divergence 挑人流分布差異大的站 |
| 空間範圍 | 依距離過濾鄰近站(1500 / 2000 公尺) | 依路線上的相鄰站數(1–4 站) |
| 嵌入維度 | 64 | 64 與 768 都比較 |
| 指標 | MAE、RMSE | MAE、MSE、MdAE |
研究動機#
尖峰離峰的落差#
過去的交通研究大多用靜態的站點特徵預測人流,但尖峰和離峰的人流差非常多,用同一組特徵在不同情境下預測,自然會產生偏差。研討會版已經證明動態嵌入有用,期刊版想回答的是:動態特徵能不能在流量變化大的站點和時間點上帶來更穩定的預測?
人流來自不同方向#
常見做法是把所有特徵串起來丟進 LSTM 之類的時間序列模型。這樣所有原始資料都用上了,但如果不同特徵的重要性差很多,模型不一定學得到。
捷運站的人流至少來自兩個方向,轉乘站甚至有四到五個來源;這些路線在尖峰和離峰對目標站的影響也不同。如果能估計每個人流來源的重要性,就能預測得更準。這就是選擇階層式注意力模型的原因:分三層估計特徵的比重,把對目標站影響小的路線權重降下來。
為什麼用 BERT 預訓練#
預訓練模型先在同一領域學大量資訊,再遷移到目標任務,在資料有限時特別有幫助。過去交通領域的預訓練多半用時間序列模型(DBN、SAE、ANN 等)。BERT 的不同之處在於它的輸出是依當下輸入動態產生的:Word2Vec、Graph Embedding 這類方法本質上是查表,同一個站永遠拿到同一個向量;BERT 則會依這個時間點的人流輸入給出對應的特徵。
相關研究#
稿件的文獻回顧分三塊:
- 交通流量預測:從傳統機器學習(SVR、ARIMA),到堆疊 auto-encoder(SAE)學深層特徵,再到結合時空特徵的圖模型(如 STGCN、動態圖神經網路)。
- 深度學習在交通的應用:捷運資料多半來自閘門進出紀錄,完整且單純。有研究用分群(站點周邊資訊,或季節、假日、平日等時間資訊)取特徵,也有大量 LSTM、LSTM + CNN、圖模型的應用;高速公路資料則多來自車輛感測器和 GPS,目標也更多樣(分車種流量、行程延遲、壅塞偵測等)。
- 預訓練交通模型:用 DBN 非監督學習人流特徵再微調、用 ANN 預訓練交通狀態、用 SAE 預訓練即時人流再接 DNN 預測公車站人流。這些研究用相對簡單的模型就得到不錯的改善,說明預訓練在交通預測上有效。
模型架構#
整體一樣分兩階段:先預訓練 BERT 人流嵌入,再接到三層的 HAN 預測下一個時間點的人流。
第一階段:四個目標的預訓練#
輸入格式和研討會版相同:兩個站各取過去 5 個時間點、分箱後的人流序列,用 [CLS] … [SEP] … [SEP] 串接並隨機遮罩。[SEP] 讓模型知道兩段序列來源不同,進而學到不同序列代表的人流意義。
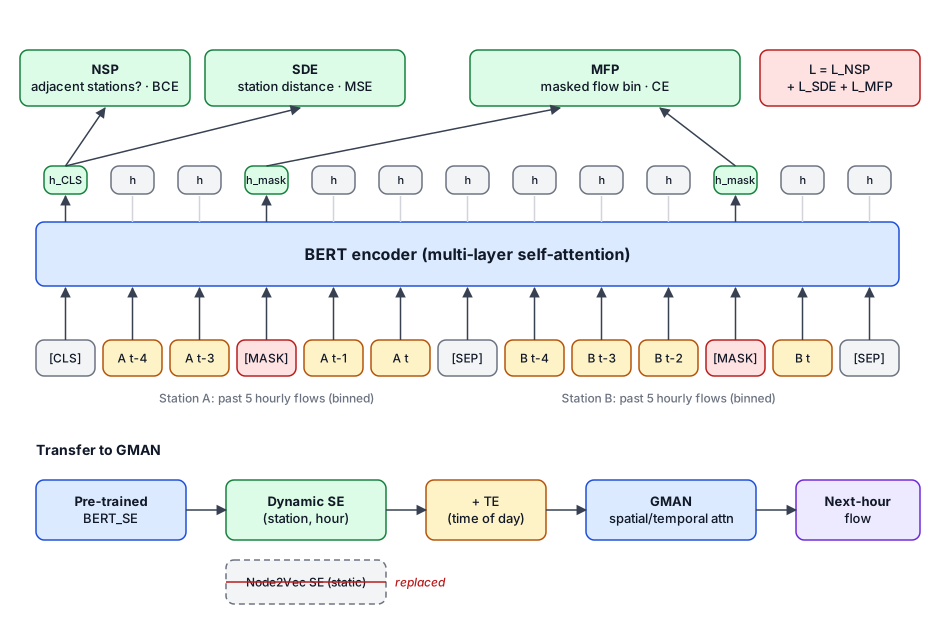
(上圖是研討會版程式的三個預測頭;期刊版改成下表的四個目標。)
期刊版以 MFP 為主目標,再加三個輔助目標,讓模型除了數值變化,也學到更多空間概念:
| 目標 | 用哪個輸出 | 預測什麼 | 為什麼需要 | 損失 |
|---|---|---|---|---|
| MFP(Mask Flow Prediction,主目標) | 被遮住位置的 h | 被遮住的人流區間 | 從時間的角度學人流變化,理解尖峰離峰的差異 | Cross-entropy |
| SRP(Same Route Prediction) | h_CLS + sigmoid | 兩段序列是否來自同一條路線 | 讓模型有路線的空間概念,理解不同輸入之間的關係 | Cross-entropy |
| ASP(Adjacent Station Prediction) | h_CLS + sigmoid | 兩段序列是否來自相鄰站 | 學相鄰站之間的人流差異與連動 | Cross-entropy |
| SDE(Station Distance Estimation) | h_CLS | 兩站直線距離 | 人流特性會隨空間改變,讓模型分辨市中心與郊區的站 | MSE |
因為 BERT 已經讓特徵經過多層 self-attention,SRP、ASP、SDE 都只需要取第一個位置 h_CLS 來預測。四個損失直接相加,用 Adam 最佳化:
L(θ_BERT) = l_MFP + l_SRP + l_ASP + l_SDE
預訓練完成後,只把隱藏層遷移過去,作為下游模型的人流特徵。
第二階段:階層式注意力模型(HAN)#
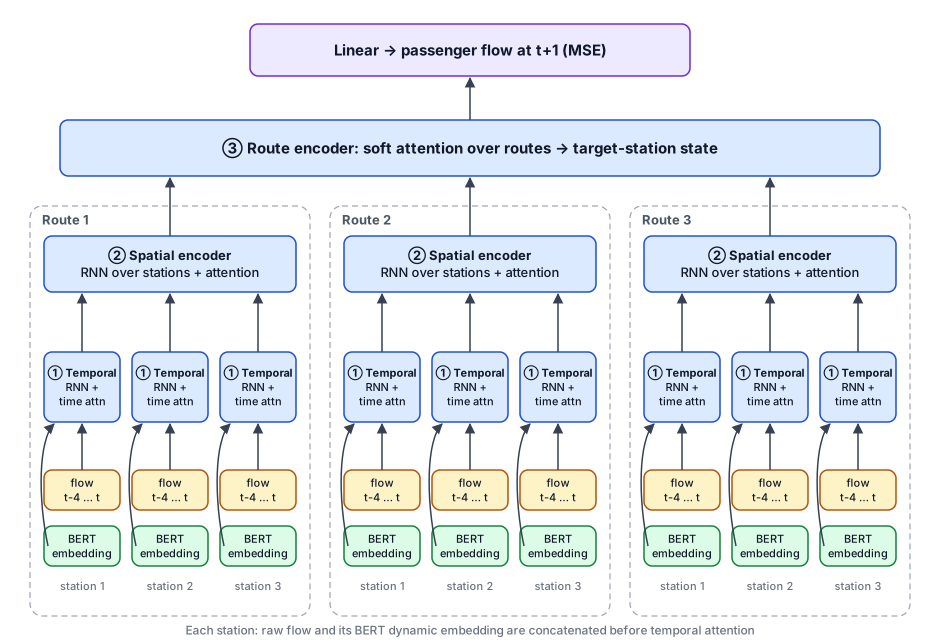
HAN 的想法來自文件分類的 Hierarchical Attention Network(字 → 句 → 文件),這裡換成時間點 → 站 → 路線。輸入是一個三維張量 X ∈ R^{R×S×T},R、S、T 分別是路線數、每條路線取的站數、時間長度。
1. 時間編碼層(Temporal Feature Encoder)
對每個站做兩件事:把原始人流序列丟進 RNN 得到隱藏狀態;同時把同一段人流丟進 BERT 得到動態嵌入。兩者串接後,用 soft attention 決定過去每個時間點的重要性:
h_t = concat[RNN(x_t), BERT(x_t)]
u_t = tanh(W_t · h_t + b_t)
α_t = softmax(u_t)
s   = Σ_t α_t · h_t          # 這個站的時間狀態
BERT 的輸出已經是估計後的隱藏狀態,所以原始資料這一側要先經過 RNN,兩邊才是同一層次的表示。
2. 空間編碼層(Spatial Feature Encoder)
同一條路線上,取目標站附近的 st 個站,把它們的時間狀態依站序丟進 RNN(站點在路線上是連續的,有順序),再用 soft attention 加權,得到這條路線對目標站的影響。輸出是 R 條路線各一個向量。
3. 路線編碼層(Route Feature Encoder)
一個站的人流可能來自好幾條路線,每條路線的來源也不同(市區、郊區、住宅區),帶給目標站的資訊也不同。路線之間沒有順序關係,所以這層只用 soft attention、不用 RNN,算出每條路線的權重後加權得到目標站的最終隱藏狀態。
4. 預測層
經過三層注意力後,隱藏向量已經包含時間、站點、路線三個面向的資訊,只要一層 Linear 就能輸出下一個時間點的人流。損失用 MSE,同樣以 Adam 最佳化。
實驗設定#
切分與超參數#
依時間切分:2017/01–2018/09 訓練、2018/10–2018/12 驗證(用來挑最佳模型)、2019/01–2019/03 測試。
| 參數 | 值 | 說明 |
|---|---|---|
| hp | 5 | 歷史人流的時間長度 |
| st | 1, 2, 3, 4 | 每條路線上取幾個相鄰站 |
| lr | 1e-3 | 學習率 |
| es | 64, 768 | BERT 預訓練嵌入維度,也是 HAN 的 hidden size |
挑站:用 KL divergence 找差異大的站#
台北捷運站數很多,實驗只取 20 站。人流分布相似的兩個站可能有相同的特性,所以挑站時用 KL divergence 計算兩站人流分布的相似度,刻意挑分布差異大、具代表性的站。這樣即使是非轉乘站,彼此的數據也差很多,可以檢驗模型在極端變化下是否依然穩健。
| 最大人流 | 平均人流 | |
|---|---|---|
| 非轉乘站 | 7,858 | 1,829 |
| 轉乘站 | 16,530 | 4,342 |
轉乘站的最大值和平均值大約是非轉乘站的兩倍,變異也大得多。代表轉乘站在不同時間點的變化很大,預測更難,但也更重要:能把轉乘站預測準,對捷運排班的幫助最大。
逐站來看,10 個非轉乘站的最大人流從 1,359 到 24,553,10 個轉乘站從 7,174 到 46,225;人流最大的轉乘站平均每小時約 15,018 人次,標準差約 8,949。
比較模型#
| 模型 | 說明 |
|---|---|
| HAN | 只用 HAN,時間編碼層不加 BERT 嵌入,只用 RNN 的輸出 |
| BERT768 | 本文主模型:時間編碼層串接 768 維的 BERT 嵌入 |
| BERT64 | BERT 預訓練的 hidden size 改成 64,RNN 輸出也改成 64;看嵌入維度的影響,也能縮短訓練時間 |
| finalBERT768 | BERT 嵌入不放在時間層,改成直接接到 HAN 最後一層(預測層前);時間層只用 RNN |
| finalBERT64 | 同上,嵌入維度 64 |
finalBERT 的動機是:BERT 的輸出已經是經過多層 attention 的高資訊向量,也許不需要再過一次 HAN,直接放在最後就夠了。
實驗結果#
一、整體表現(20 站平均)#
| 模型 | MAE | MSE | MdAE |
|---|---|---|---|
| HAN | 290.58 | 443,642.63 | 230.08 |
| finalBERT64 | 187.36 | 142,881.13 | 138.38 |
| finalBERT768 | 185.54 | 128,920.94 | 142.22 |
| BERT64 | 189.38 | 164,135.76 | 140.52 |
| BERT768 | 175.84 | 128,396.65 | 129.58 |
BERT768 在三個指標都是最好。
- 加入 BERT 大幅改善:所有 BERT 系列模型都遠勝純 HAN,MAE 從 290.58 降到 175.84,MSE 降到不到原本的三分之一。
- 768 維比 64 維好:不論嵌入放在哪裡,768 維的 MSE(約 12.8 萬)都比 64 維好,表示嵌入維度越高,帶的資訊越豐富。
- 放在時間層比放在最後好:finalBERT 的 MAE 都在 185–187 左右,仍不如 BERT768 的 175.84。代表 BERT 產生的向量再經過 HAN 的多層 attention,還能進一步提升效果。
二、依時段比較#
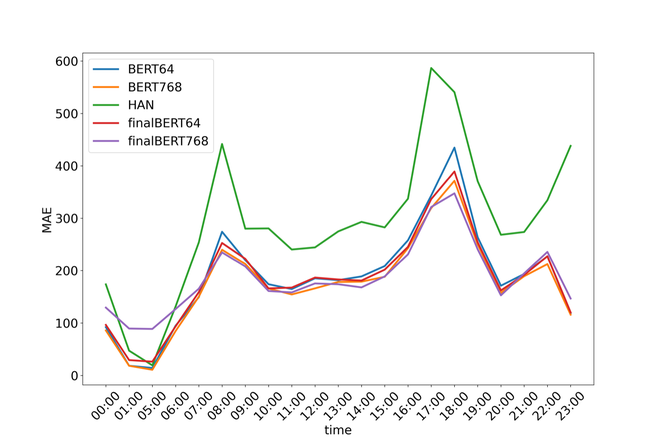
橫軸是小時(捷運 02:00–04:00 不營運,沒有資料),縱軸是 MAE:
- HAN 在每個時段幾乎都最差,尤其是 07:00–09:00 和 16:00–19:00 兩個尖峰,17:00 的誤差接近 600。
- 加入 BERT 的模型把尖峰誤差壓低一大截。這說明人流變化大的時候,動態嵌入最能發揮作用。
- 23:00 人流快速下降時,HAN 也預測得很差,BERT 系列明顯較好。
- 清晨人流低、變化小的時段,兩類模型差不多。圖上看得到 finalBERT768 在 01:00–05:00 反而比較差。
- 兩個尖峰中,BERT64 是四個 BERT 模型裡最差的,其次是 finalBERT64。高變異的時段需要更高維的向量來表達。
三、轉乘站 vs 非轉乘站#
逐站比較 HAN 和 BERT 系列哪個比較好:
| 勝出模型 | 轉乘站(10 站) | 非轉乘站(10 站) |
|---|---|---|
| HAN | 1 | 6 |
| BERT 系列 | 9 | 4 |
轉乘站 10 站裡有 9 站是 BERT 系列較好;非轉乘站則是 HAN 稍好。和研討會版的結論一致:動態嵌入在變化大的轉乘站優勢明顯,在非轉乘站只是略遜。
四、動態向量視覺化#
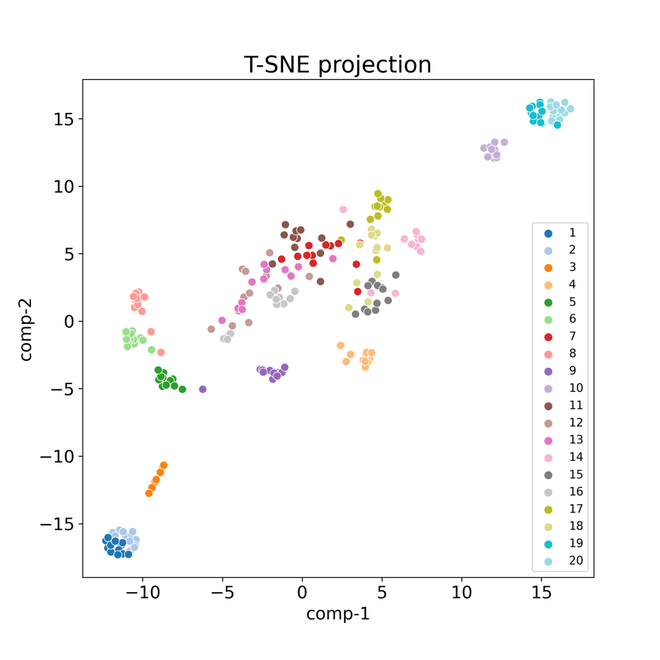
把 BERT 輸出的動態向量用 t-SNE 降到二維。每個站取 2017 年的資料、按月平均,所以每站 12 個點,顏色代表站點 ID(1–10 非轉乘、11–20 轉乘):
- 整體從左下到右上分布,人流越大的站越靠右上,非轉乘站 1–10 大多在左下。
- 10 號雖然是非轉乘站,但人流比很多站都高,所以也落在右上。
- 19、20 號是台北捷運人流最大的兩個站,除了都是轉乘站,彼此也相鄰,所以分布幾乎重疊。
- 1、2 號也很接近,但原因相反:它們是路線末端的站,人流都很低。
換句話說,BERT 學到的向量確實反映了站點的人流規模與空間關係,而不是隨機的編碼。
結論與我的觀察#
結論:用多個自監督目標預訓練 BERT 學習人流特性,再接到從時間、站點、路線三個面向關注捷運資料的 HAN,預測未來的人流變化。預訓練特徵能提升 HAN 的表現,尤其能有效預測高變化量的捷運人流,模型在不同人流情境下有較好的泛化性與穩健性。未來希望用更多不同的目標預訓練 BERT,加深模型對人流的理解。
回頭看的觀察:
- 從數字量級看,誤差應是原始人次的尺度(MAE 約 175),和研討會版 log 正規化後的數字不能直接比較;兩篇的下游模型、挑站方式也不同。
- 非轉乘站仍是 HAN 略勝,動態嵌入的價值集中在高變異的情境。
- 768 維比 64 維好,但訓練成本也高,實務上要在效果和成本之間取捨。
程式碼與資源#
- 預訓練 BERT 動態表徵的程式碼在 IIAI-AAI 2021 repo。
- HAN 下游模型的程式碼沒有放上 GitHub。
- 本機保留了期刊稿各版本(
交通期刊_Howard_202106xx–交通期刊_英文_Howard_20220105)以及整理過的交通流量預測文獻(EndNote)。